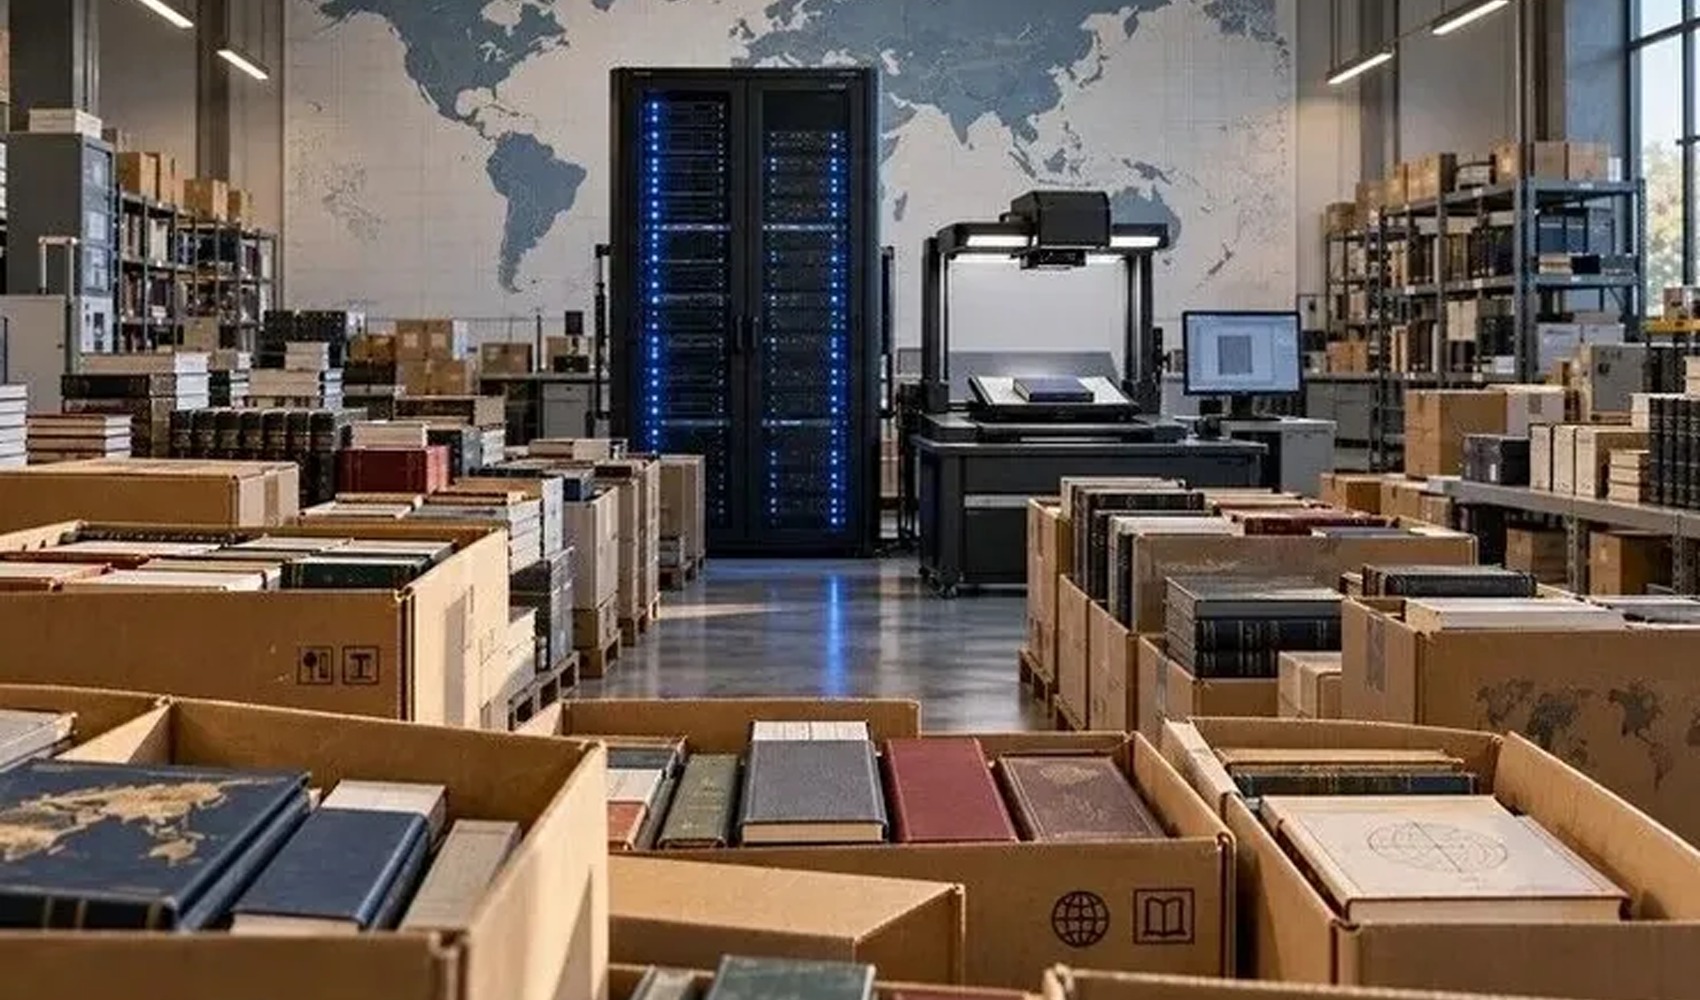
Les tentatives des entreprises d'intelligence artificielle de transformer des livres imprimés et numériques en vastes ensembles de données ont relancé le débat sur les droits d'auteur et l'utilisation des données dans le secteur de l'édition.
Le professeur Selçuk Beşir Demir a révélé qu'ils avaient refusé la demande d'une entreprise mondiale souhaitant accéder à 17 000 livres académiques. M. Demir a souligné que de telles demandes ne peuvent être considérées comme de simples activités techniques de collecte de données, mais qu'elles pourraient avoir des conséquences graves pour les éditeurs, les auteurs et la production académique.
Qualifiant ce processus de « guerre entre la Silicon Valley et l'industrie de la cellulose », M. Demir a insisté sur la nécessité de protéger les droits d'auteur et les mécanismes d'autorisation pour les contenus utilisés dans l'entraînement des modèles d'intelligence artificielle.
La préoccupation majeure dans le monde de l'édition est que la numérisation massive des livres pour l'entraînement des systèmes d'IA affaiblisse les revenus, le contrôle et les droits de citation des auteurs. Il est souligné que cette situation pourrait accroître les risques d'« exploitation des données » et de rétrécissement du marché, en particulier pour les publications académiques en turc.
Tout en appelant à la mise en place d'un cadre de protection plus solide contre les violations des droits d'auteur, M. Demir a exprimé la nécessité de garantir la production de contenus locaux dans le processus de transformation numérique de l'édition académique.
Source de l'actualité: 12punto